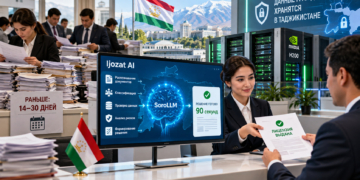
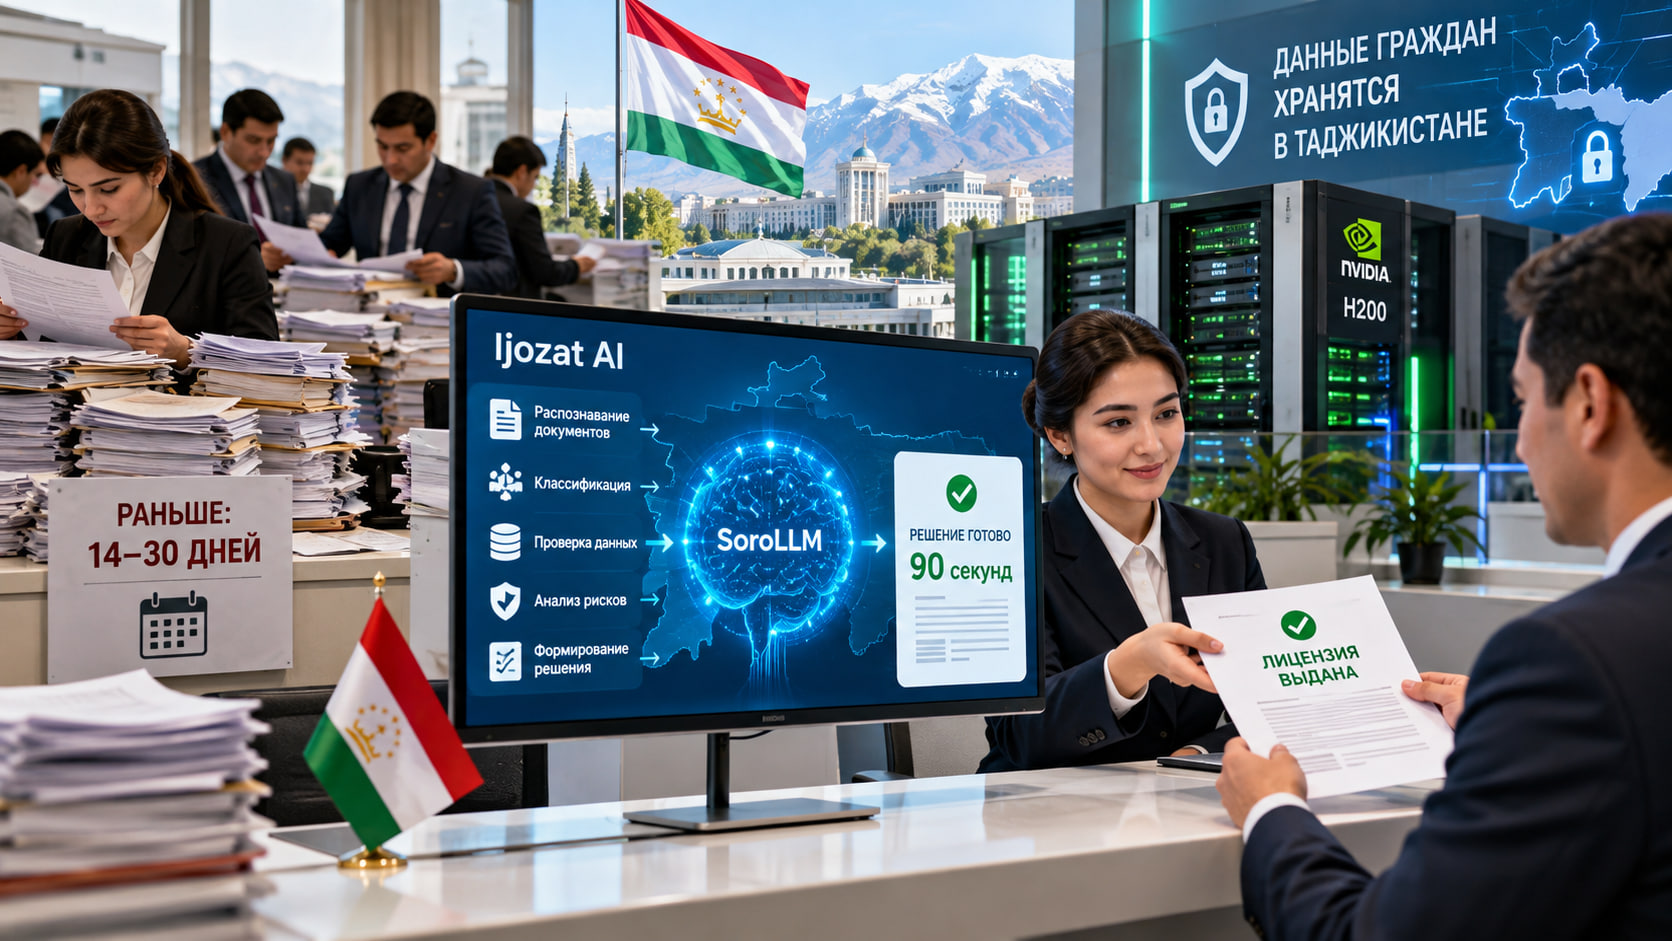
В Таджикистане внедряется новая система лицензирования на основе искусственного интеллекта, позволяющая сократить время обработки заявок с 14–30 дней примерно до 90 секунд. Технологическая платформа создана с использованием инфраструктуры американской компании NVIDIA и обеспечивает хранение персональных данных граждан исключительно на территории страны. Об этом 29 октября сообщает NVIDIA в материале, посвящённом цифровизации государственных услуг в Таджикистане.
Проект направлен на модернизацию системы предоставления государственных услуг предпринимателям и гражданам. Вместо традиционного бумажного документооборота внедряется защищённая цифровая платформа, способная автоматически обрабатывать документы, проверять сведения и формировать заключения по вопросам выдачи лицензий и разрешений.
Для реализации проекта правительство Таджикистана сформировало партнёрскую экосистему, объединившую три технологические компании: darya.ai, zehnlab.ai и Epsilon3.ai. Каждая из них отвечает за отдельное направление работы системы.
Компания darya.ai предоставляет вычислительные мощности, zehnlab.ai разработала первую национальную большую языковую модель Таджикистана, а Epsilon3.ai создала приложение для автоматизации лицензирования с использованием искусственного интеллекта.
От бумажных документов к цифровой системе
Ранее государственные учреждения Таджикистана, отвечающие за выдачу лицензий и разрешений для предпринимательской деятельности, работали преимущественно с бумажными документами и отсканированными PDF-файлами.
Сотрудникам приходилось вручную извлекать необходимые сведения из поступающих документов, а затем проверять их по нескольким информационным системам, не связанным между собой.
В результате рассмотрение одной заявки занимало от 14 до 30 дней. При этом на обработку каждого обращения квалифицированный специалист тратил до 60 минут рабочего времени.
В периоды повышенной нагрузки количество необработанных заявлений увеличивалось, что приводило к дополнительным задержкам для предпринимателей.
Сложность заключалась также в том, что документы поступали на таджикском, русском и английском языках. Устаревшие информационные системы не могли обеспечить полноценную обработку материалов на нескольких языках.
Кроме того, существующая инфраструктура не имела современных интерфейсов программирования приложений (API), необходимых для подключения новых цифровых решений.
Ещё одним важным условием стало соблюдение требований по защите персональных данных. Государственные учреждения Таджикистана не могли использовать общедоступные зарубежные облачные платформы для обработки информации граждан, поскольку все данные должны храниться внутри страны.
Поэтому для проекта потребовалась собственная вычислительная инфраструктура, способная работать с искусственным интеллектом без передачи информации за пределы Таджикистана.
Серверы NVIDIA H200 размещены в Дарвозе
Вычислительную основу новой системы обеспечивает компания darya.ai, располагающая собственным дата-центром в Дарвозе.
После предыдущих этапов развития проекта вся необходимая вычислительная инфраструктура была размещена непосредственно на территории Таджикистана.
В настоящее время обучение моделей искусственного интеллекта, обработка запросов и другие вычислительные процессы выполняются на сервере Supermicro, оснащённом графическими процессорами NVIDIA H200.
Для работы используется программная платформа NVIDIA CUDA, обеспечивающая ускорение вычислений с помощью графических процессоров.
Такая архитектура позволяет обрабатывать государственные документы с использованием искусственного интеллекта, одновременно соблюдая национальные требования к хранению и защите данных.
По данным NVIDIA, новая система способна формировать результаты обработки заявок на получение лицензий и разрешений примерно за 90 секунд. При этом решения, подготовленные с помощью искусственного интеллекта, могут проверяться и проходить аудит.
В Таджикистане разработали собственную языковую модель SoroLLM
Одной из ключевых задач проекта стало создание искусственного интеллекта, способного полноценно понимать таджикский язык.
Как отмечает NVIDIA, на таджикский язык приходится менее 0,01% материалов в массиве данных Common Crawl, который используется для обучения современных языковых моделей.
Это означает, что таджикский язык крайне слабо представлен в обучающих данных ведущих систем искусственного интеллекта.
Для решения этой проблемы компания zehnlab.ai разработала национальную большую языковую модель Soro 27B, также известную как SoroLLM.
При её создании специалисты использовали модели с открытыми весами, которые дополнительно обучили на специально подготовленном корпусе таджикоязычных текстов.
Затем модель прошла настройку с использованием десятков тысяч примеров на таджикском языке, что позволило адаптировать её для выполнения различных инструкций и обработки запросов.
Первая национальная большая языковая модель Таджикистана была представлена в июне 2025 года при участии президента страны Эмомали Рахмона.
По информации разработчиков, Soro 27B превосходит все общедоступные модели сопоставимого размера по результатам шести тестов, предназначенных для оценки качества работы искусственного интеллекта с таджикским языком.
В дальнейшем команда рассматривает возможность использования технологии NVIDIA NeMo для дополнительного обучения модели и распределения вычислительных задач между несколькими графическими процессорами NVIDIA H200.
Создана система безопасности искусственного интеллекта на таджикском языке
Параллельно специалисты zehnlab.ai разработали Soro Guard 1B — первую модель для проверки безопасности контента на таджикском языке.
Поскольку существовавшие готовые решения не поддерживали таджикский язык, разработчикам пришлось создать собственную систему на основе технологий NVIDIA.
В качестве основы использовались набор данных и классификация категорий безопасности NVIDIA Nemotron Content Safety. Систему адаптировали для таджикского и русского языков, а её архитектуру построили по образцу NemoGuard.
Новая модель предназначена для проверки пользовательских запросов и ответов искусственного интеллекта с точки зрения безопасности.
По данным разработчиков, Soro Guard 1B демонстрирует показатель unsafe-F1 выше 89% при выявлении небезопасного контента на таджикском, русском и английском языках.
Как работает система лицензирования Ijozat AI
Непосредственно за автоматизацию процесса лицензирования отвечает платформа Ijozat AI, разработанная компанией Epsilon3.ai.
Она представляет собой комплекс программных сервисов, использующих технологии Kubernetes и Docker, и объединяет несколько специализированных агентов искусственного интеллекта.
Каждый агент выполняет определённую задачу при обработке поступающих заявлений.
На первом этапе система оптического распознавания символов (OCR) извлекает необходимые сведения из отсканированных документов на таджикском, русском и английском языках.
Затем специальный агент определяет тип документа и выбирает порядок его дальнейшей обработки.
После этого другие агенты проверяют идентификационные и юридические сведения, сопоставляя их с информацией государственных реестров и баз данных.
Отдельный агент анализирует возможные риски и выявляет подозрительные или нестандартные случаи, которые требуют дополнительного рассмотрения специалистом.
Центральную роль в работе платформы играет национальная языковая модель SoroLLM.
Она анализирует нормативные требования, отвечает на вопросы заявителей и формирует структурированные заключения по результатам проверки документов.
Благодаря этому сотрудники государственных органов могут рассматривать уже подготовленные системой заключения вместо самостоятельного изучения большого количества бумажных документов.
При этом случаи, вызывающие сомнения, направляются на дополнительную проверку человеком.
Время обработки заявок сократилось до 90 секунд
Использование искусственного интеллекта позволило существенно ускорить обработку документов в системе государственного лицензирования.
Если ранее рассмотрение заявки могло занимать от двух до четырёх недель, то теперь платформа способна выполнять автоматизированную обработку примерно за полторы минуты.
При этом вычислительные процессы осуществляются на территории Таджикистана с использованием инфраструктуры NVIDIA, размещённой в дата-центре darya.ai.
Разработчики также рассматривают возможности дальнейшего повышения производительности системы.
В частности, планируется оценить применение технологии NVIDIA TensorRT для обслуживания языковой модели Soro 27B при увеличении количества обращений.
Для последующего обучения и развития национальной языковой модели рассматривается использование NVIDIA NeMo.
Ожидается, что такие технологические решения позволят увеличить количество одновременно обрабатываемых заявок и обеспечить дальнейшее масштабирование платформы по мере роста спроса на цифровые государственные услуги.