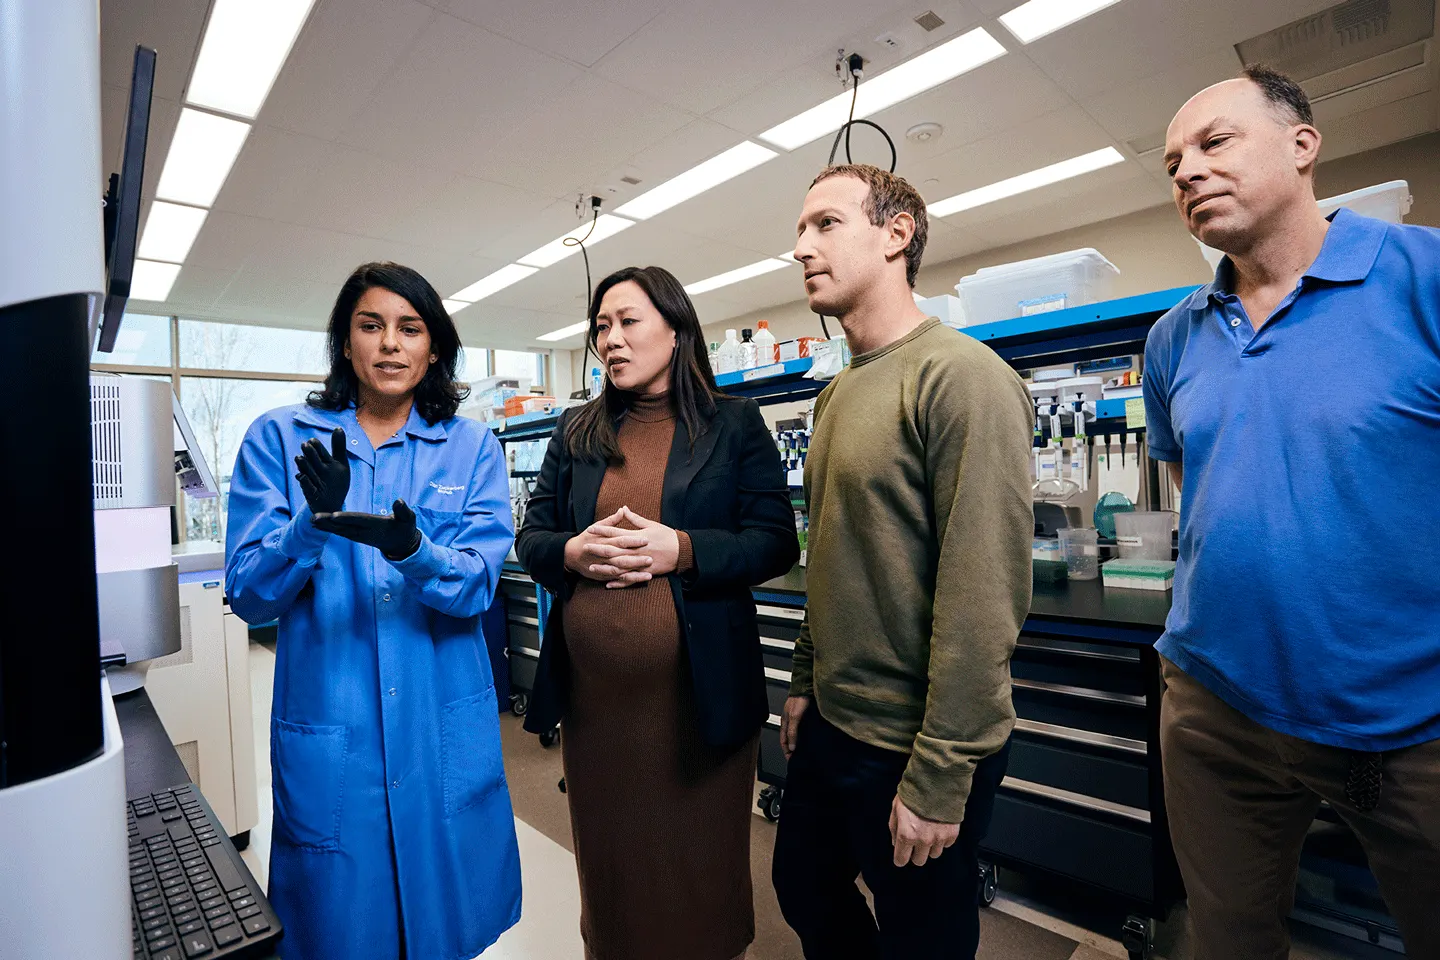
Марк Цукерберг и его супруга Присцилла Чан через научно-благотворительную организацию Chan Zuckerberg Biohub запустили масштабный проект по созданию «универсальной виртуальной клетки». В инициативе участвуют Google DeepMind, Isomorphic Labs, Meta и государственные учреждения США. Об этом 7 октября сообщает Tengri Life со ссылкой на Axios.
Речь идет не о создании физической клетки, а о разработке ее цифровой копии на основе искусственного интеллекта.
Главная цель проекта — сформировать крупнейшую в истории базу стандартизированных биологических данных, включая данные геномики отдельных клеток. Для обучения моделей искусственного интеллекта планируется оцифровать миллиарды, а в перспективе — триллионы клеток.
Создаваемая «виртуальная клетка» должна работать как прогностическая модель. С ее помощью ученые смогут проводить сложные биологические эксперименты в цифровой среде — in silico, то есть на компьютере. Это позволит за считанные секунды оценивать, как клетка может реагировать на новые лекарства, генетические изменения или вирусы.
Инициатива предусматривает сбор и унификацию больших массивов биологических данных для создания «универсальной виртуальной клетки». На первом этапе планируется сформировать общую карту клеточной биологии и реакций клеток на различные изменения.
Коммерческие партнеры проекта получат эксклюзивный доступ к собранным данным сроком на один год. После этого данные планируется сделать общедоступными.
Руководитель научного отдела Biohub Алекс Ривз заявил Axios, что увеличение объема логического анализа и интеллекта при постановке лабораторных вопросов позволит значительно повысить ценность получаемых эмпирических результатов.
По словам Ривза, искусственный интеллект уже способен работать с белками и биологическими структурами. Однако моделирование целой живой клетки требует на порядки большего объема данных, которые необходимо получать в реальном мире.
«Мы находимся в начале новой научной парадигмы в области искусственного интеллекта», — сказал Ривз.
Он отметил, что биологии необходим «эмпирический ИИ» — модели, обученные на биологических данных и способные точно прогнозировать процессы, происходящие в физическом мире.
В течение года после получения первого крупномасштабного набора данных разработчики планируют обучать модели, оценивать их качество и определять, какие типы биологических данных позволяют улучшить точность прогнозов.
«Это сработало во всех областях, и это работает и в биологии», — заявил Ривз, говоря об успехах искусственного интеллекта в области белковой биологии.
В перспективе такие модели могут использоваться для выявления молекулярных причин заболеваний у конкретного человека и подбора оптимальных вмешательств. Кроме того, проект может способствовать развитию исследований в области старения и регенерации.